Ako zistiť, či AI automatizácia vo firme naozaj funguje?
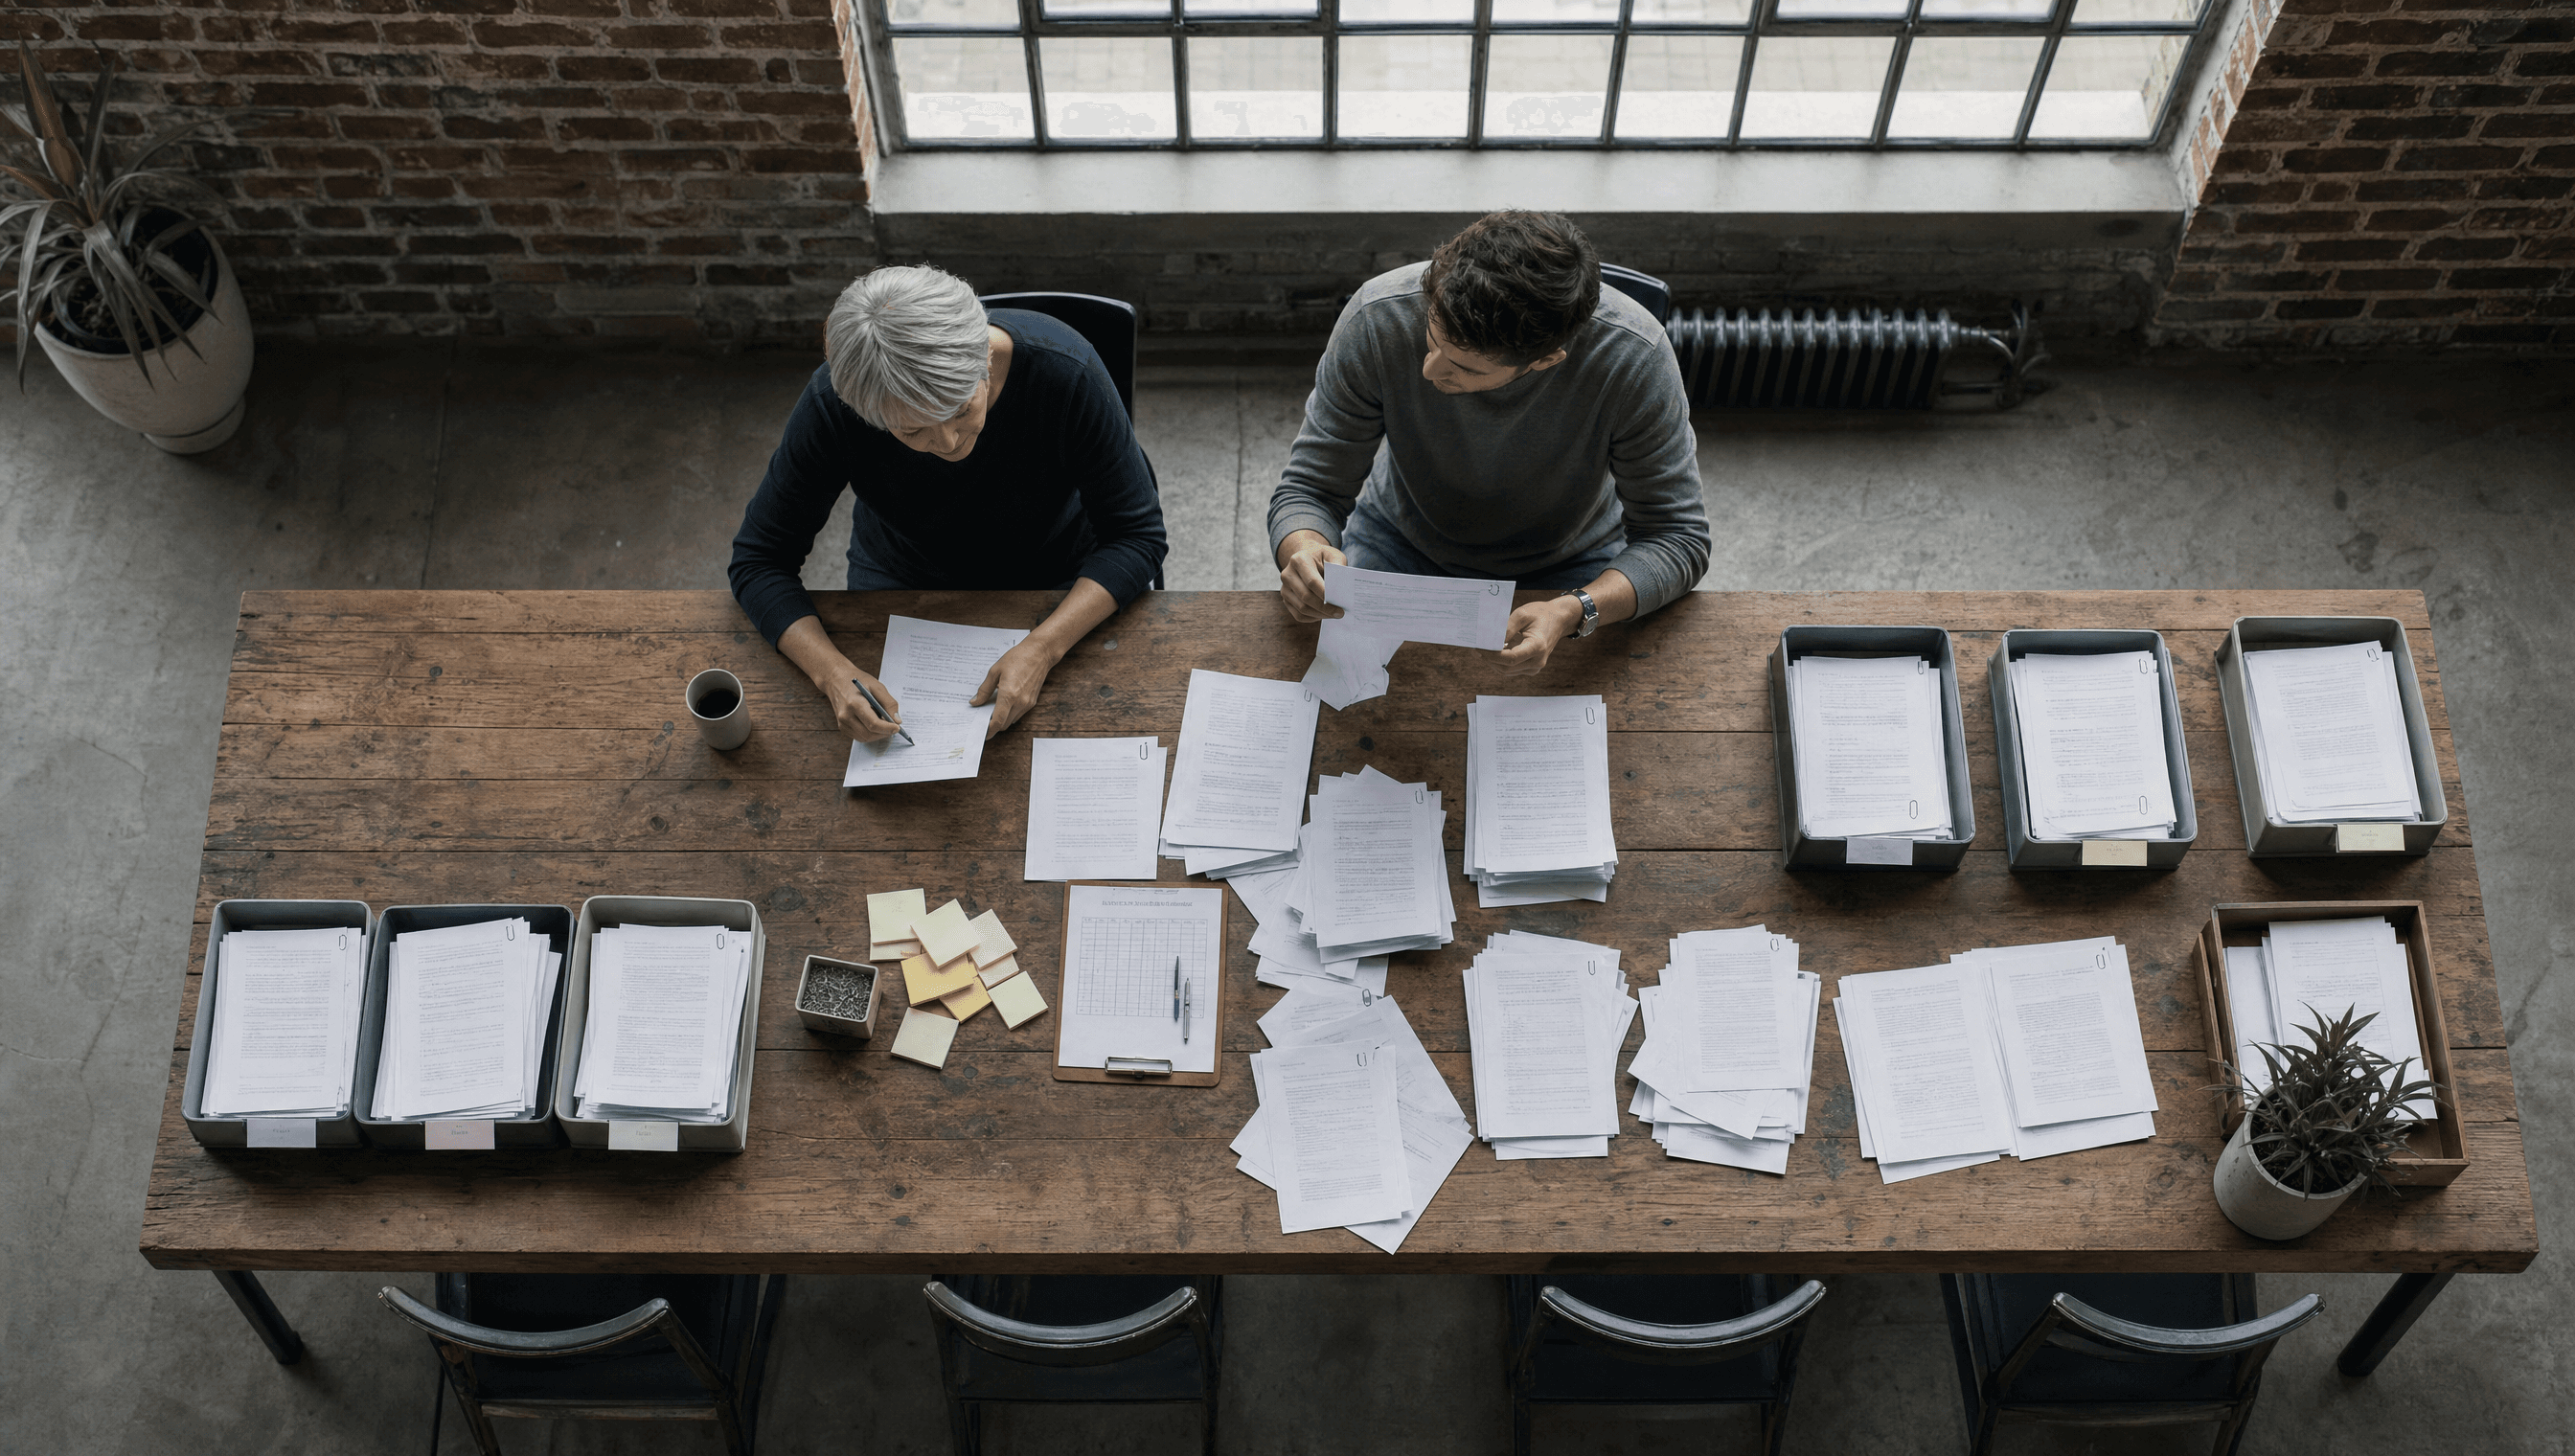
Testovanie AI automatizácií stojí na jednoduchom princípe: zoberiete 20 až 50 reálnych prípadov z vašej prevádzky, určíte správnu odpoveď a každú zmenu v automatizácii overíte práve na nich. Bez takejto testovacej sady len hádate, či nový model alebo upravený prompt pomohol, alebo uškodil.
Presne tento postup 28. septembra 2026 opísal Anthropic v článku Automating eval design and hillclimbing with Claude a doplnil ho o dva nové príkazy v Claude Code. Na interných tiketoch zákazníckej podpory tak zvýšili presnosť rozhodnutí a zároveň znížili náklady na jeden tiket zo 4,6 centa na približne 1 cent. Pre slovenské malé a stredné firmy je to dôležité práve teraz, lebo nové modely vychádzajú takmer každý týždeň a otázka „máme prejsť na novší?“ sa bez merania nedá zodpovedne zodpovedať. V článku nájdete, čo presne Anthropic ukázal, ako si podobný test postaviť aj bez vývojárskeho tímu a na čo si dať pozor.
Čo presne Anthropic oznámil a prečo na tom záleží?
Anthropic pridal do svojho balíka pre prácu s API dva kroky. Prvý, `build-eval`, pomôže postaviť testovaciu sadu priamo z reálnych dát: z prepisov komunikácie, z nahlásených chýb a tiketov podpory, prípadne z niekoľkých ručne napísaných príkladov. Druhý, `hillclimb`, potom automatizáciu vylepšuje po jednej zmene a každú zmenu nechá overiť na príkladoch, ktoré počas úprav nikdy nevidel. Ak sa zlepší len „cvičná“ časť a skrytá nie, zmenu vráti späť.
Pre bežnú firmu nie je podstatný konkrétny príkaz, ale filozofia za ním. AI riešenia nasadené na zákaznícke e-maily, triedenie faktúr alebo odpovede z internej znalostnej bázy sa správajú pravdepodobnostne. Zmena jednej vety v zadaní môže zlepšiť desať prípadov a pokaziť tri iné, ktoré si nikto nevšimne. Ak už teraz riešite, kto a ako na automatizácie dohliada, nadväzuje to na tému z nášho článku o kontrole AI automatizácií: dohľad bez merania je len pocit.
Na slovenskom trhu vidíme, že firmy riešia hlavne otázku „ktorý model“. Anthropic však ukazuje, že dôležitejšie je mať nástroj, ktorým výber modelu overíte na vlastných dátach, nie na verejných rebríčkoch.
Ako si postaviť testovaciu sadu pre AI automatizáciu v praxi?
Postup sa dá zjednodušiť do niekoľkých krokov, ktoré zvládne aj menší tím. Začnite prípadmi z reality: exportujte 30 až 50 skutočných e-mailov, tiketov alebo dokumentov, ktoré má automatizácia spracovať. Anthropic odporúča poradie zdrojov: najprv reálna prevádzka (po kontrole citlivých údajov), potom nahlásené chyby a tikety, potom ručne písané príklady a až nakoniec syntetické prípady. Ku každému prípadu zapíšte správny výsledok, napríklad „reklamácia, poslať na oddelenie servisu“.
Potom zvoľte najlacnejší spôsob hodnotenia. Ak má výstup pevné možnosti (kategória, schválené áno/nie, správne vyplnené pole), stačí jednoduchá kontrola kódom. Ak je výstup voľný text, napríklad návrh odpovede zákazníkovi, použite druhý model ako hodnotiteľa s jasnými pravidlami v tvare overiteľných tvrdení, nie známku od 1 do 5. Podľa Anthropicu by hodnotiaci model nemal byť ten istý, ktorý testujete, a niekoľko ohodnotených prípadov si má vždy prečítať človek.
Tretím krokom je rozdelenie sady. Časť prípadov slúži na ladenie, zvyšok schováte a pozriete sa naň až na konci. Až potom má zmysel meniť zadanie, model alebo nastavenie. Takýto proces staviame ako súčasť dodávky AI riešení a automatizácií, aby mal klient pri každej zmene číslo, nie dojem.
Aké čísla ukázal test na tiketoch zákazníckej podpory?
Najzaujímavejší je príklad s internou sadou 44 tiketov podpory, z ktorých 30 slúžilo na ladenie a 14 zostalo skrytých. Východiskový stav bol model Opus 4.8 s vysokou úrovňou uvažovania: presnosť rozhodnutí 74,4 % a náklady 4,6 centa na tiket. Automatické ladenie najprv vyčistilo zadanie, odstránilo zbytočné povinné kroky a protichodné pravidlá, a vyskúšalo novší Opus 5.5 na nízkej úrovni uvažovania. Výsledok: 87,8 % pri 1,9 centa na tiket.
Keďže novší model latku prekonal, proces skúsil ešte lacnejší Sonnet 5 na nízkej úrovni. Dosiahol 88,9 % za približne 1 cent na tiket. Po doplnení pravidiel smerovania a krížovej kontroly limitu refundácie vystúpila presnosť na ladiacej sade na 98,9 %. Na 14 skrytých tiketoch, ktoré proces nikdy nevidel, skončila finálna konfigurácia na 90,5 % oproti pôvodným 78,6 %, a to približne za pätinu pôvodných nákladov.
Druhý príklad z článku ukazuje smerovanie e-mailov do správnych priečinkov: sada 24 e-mailov, východisková presnosť 68,1 % a po úprave definícií priečinkov a pravidla pre nejasné prípady 87,5 %. Pre slovenskú firmu, ktorá denne triedi stovky e-mailov od zákazníkov a dodávateľov, je to presne typ úlohy, kde sa testovanie oplatí najviac. Pri objemoch v EÚ navyše rastie aj tlak na dokumentovanie toho, ako automatizované rozhodnutia vznikajú, a testovacia sada je prirodzený dôkaz.
Aké chyby robia firmy pri testovaní AI automatizácií?
Testujú na príkladoch, ktoré si vymysleli. Ručne písané prípady bývajú čistejšie a ľahšie než reálna pošta. Automatizácia potom v teste exceluje a v prevádzke zlyháva. Vždy začnite reálnymi dátami a vymyslené prípady používajte len na doplnenie.
Ladí sa priamo na chyby, ktoré videli. Ak neúspešný prípad skopírujete do zadania ako vzor, test prejde, ale v praxi sa nič nezlepší. Anthropic to nazýva preučenie na testovaciu sadu a odporúča mať skrytú časť prípadov, na ktorú sa pri úpravách nepozeráte.
Neveria číslam, ale ani ich nekontrolujú. Chybný hodnotiteľ je podľa článku jedným z najčastejších dôvodov zlých výsledkov. Ak niektorý prípad zlyháva vždy, bez ohľadu na model, problém je možno v zadaní alebo v očakávanej odpovedi, nie v AI. Pravidelne si prečítajte niekoľko ohodnotených výstupov.
Čo môže malá alebo stredná firma urobiť tento týždeň?
Na začiatok netreba nový softvér, stačí disciplína. Tieto kroky zvládnete za pár dní:
- Vyberte jeden proces, ktorý už AI spracúva alebo ho chcete automatizovať, napríklad triedenie prichádzajúcich e-mailov alebo kategorizáciu faktúr.
- Exportujte 30 až 50 reálnych prípadov a odstráňte z nich osobné údaje, ktoré na test nepotrebujete.
- Zapíšte správne výsledky s človekom, ktorý proces pozná. Pri nejasných prípadoch sa dohodnite, lebo ak sa nezhodnú dvaja odborníci, AI to nezvládne tiež.
- Zmerajte súčasný stav vrátane nákladov na jeden prípad. Až potom skúšajte lacnejší model alebo nové zadanie. Viac o tom, prečo sa oplatí oddeliť rozhodovanie od drahých modelov, píšeme v článku o lacnejšej AI automatizácii.
- Odložte si časť prípadov bokom a použite ich len na záverečné overenie pred nasadením zmeny.
Ak niečo z toho nejde, napríklad nemáte kde exportovať dáta alebo neviete, aký je správny výsledok, je to cenná informácia sama osebe. Proces zrejme ešte nie je pripravený na automatizáciu.
Záver
Testovanie AI automatizácií prestáva byť doménou veľkých technologických firiem. Novinka od Anthropicu ukazuje, že s niekoľkými desiatkami reálnych prípadov a skrytou kontrolnou sadou sa dá zároveň zlepšiť presnosť a znížiť náklady, v ich teste približne na pätinu.
Kto si testovaciu sadu postaví dnes, môže každý nový model, ktorý vyjde budúci týždeň, overiť za pár hodín namiesto dohadov.
Ako Vám S Tým Pomôže netWRK
netWRK je štúdio z Bratislavy. Slovenským firmám vyvíjame softvér na mieru a nasadzujeme AI riešenia a automatizácie plne integrované s ich dátami a systémami:
- AI riešenia a automatizácie: automatizácia opakujúcich sa procesov s validačnou vrstvou, kde tam, kde treba, rozhoduje človek.
- Softvér na mieru (CRM, ERP, portály): systémy presne podľa vašich procesov, bez licencií za funkcie, ktoré nepoužívate.
- AI konzultácie a stratégia: audit procesov a roadmapa nasadenia s odhadom nákladov a času.
👉 Dohodnúť bezplatný audit · 👉 AI riešenia a automatizácie · 👉 Softvér na mieru · 👉 Ďalšie články na blogu
Časté Otázky (FAQ)
Koľko príkladov potrebujem na testovanie AI automatizácie?
Na začiatok stačí 30 až 50 reálnych prípadov z vašej prevádzky. Anthropic vo svojom príklade pracoval so sadou 44 tiketov, z ktorých 14 zostalo skrytých na záverečné overenie. Dôležitejšia než veľkosť je reprezentatívnosť, teda aby sada obsahovala aj ťažké a nejasné prípady.
Oplatí sa prejsť na najnovší AI model?
Nie automaticky. V teste Anthropicu lacnejší model po úprave zadania dosiahol lepšiu presnosť než pôvodná drahšia konfigurácia, a to približne za pätinu nákladov. Rozhodnutie by ste mali urobiť až po zmeraní na vlastných dátach.
Čo je preučenie AI automatizácie na test?
Je to stav, keď automatizácia vyzerá výborne na testovacích príkladoch, ale v reálnej prevádzke sa nezlepší. Vzniká, keď sa zadanie ladí priamo na konkrétne chyby z testu. Riešením je skrytá časť prípadov, ktorú pri úpravách nepoužívate.
Ako mi s testovaním AI automatizácií pomôže netWRK?
Pomôžeme vám vybrať vhodný proces, pripraviť testovaciu sadu z vašich reálnych dát a nastaviť meranie presnosti aj nákladov. Automatizáciu potom nasadíme tak, aby bola každá ďalšia zmena overená číslami. Začať môžete bezplatným auditom.
netWRK, AI riešenia a softvér na mieru, Bratislava, Slovensko
📧 netwrk@netwrk.sk · 📞 +421 950 595 600 · 🌐 netwrk.sk · LinkedIn